Appearance
Aprendizaje no supervisado
Clustering (o agrupamiento) es una técnica de aprendizaje no supervisado cuyo objetivo es agrupar automáticamente datos similares entre sí en grupos llamados clústeres, sin necesidad de etiquetas o categorías predefinidas. Están muy ligados a la ciberseguridad ya que los ciber atacantes realizan varias acciones similares hasta encontrar la correcta.
Kmeans
Es un algoritmo de aprendizaje no supervisado que agrupa un conjunto de datos en K clústeres (grupos), donde cada punto pertenece al clúster con el centroide más cercano.
La idea es encontrar K centros (centroides) de tal forma que los puntos dentro de un clúster estén lo más cerca posible de su centroide, y lo más lejos posible de los otros.
Proceso de funcionamiento:
- Elegir K: Número de clústeres que se desean encontrar.
- Inicializar K centroides de forma aleatoria.
- Asignación: Cada punto se asigna al centroide más cercano.
- Actualización: Se recalculan los centroides como el promedio de todos los puntos asignados a ese clúster.
- Repetir pasos 3 y 4 hasta que:
- Los centroides no cambien significativamente
- O se alcance un número máximo de iteraciones
Cada grupo tiene su propio centroide, y los puntos se agrupan por cercanía.
Ventajas
- Rápido y fácil de implementar.
- Escalable a grandes conjuntos de datos.
- Funciona bien cuando los clústeres son esféricos y balanceados.
Desventajas
- Se deben intuir el número de clusters.
- Los resultados pueden cambiar según se inicialicen los centroides.
- Sensible a:
- Escala de los datos
- Valores atípicos (outliers)
- Inicialización de los centroides
- Solo detecta clústeres de forma convexa (no funciona bien con formas complejas).
DBSCAN
DBSCAN (Density-Based Spatial Clustering of Applications with Noise) es un algoritmo de clustering basado en densidad. A diferencia de K-Means, no necesita saber cuántos clústeres hay y puede detectar clústeres de forma arbitraria (no solo esféricos) y filtrar ruido (outliers).
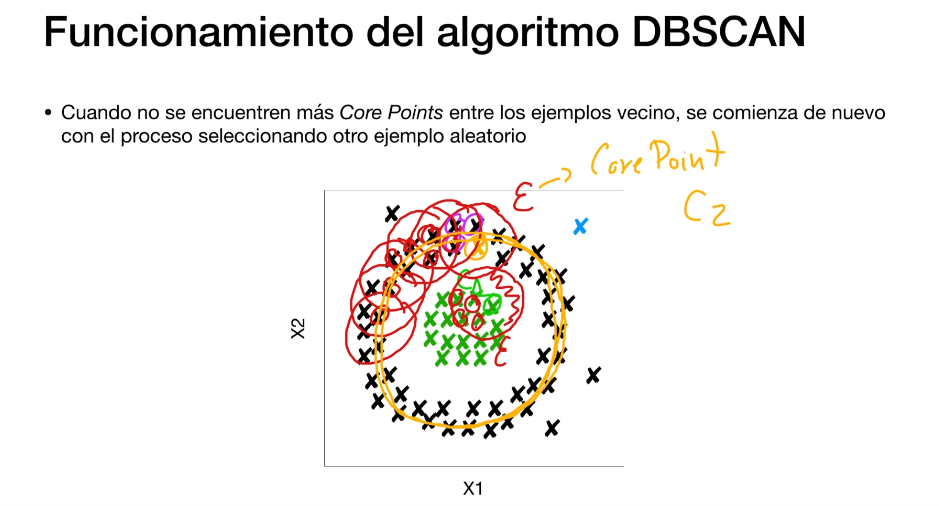
DBSCAN agrupa puntos que están cerca unos de otros según una densidad mínima, y clasifica los puntos como:
- Núcleo (core point): tiene suficientes vecinos cercanos.
- Alcanzable por densidad (border point): no cumple los vecinos mínimos, pero está cerca de un punto núcleo.
- Ruido (noise): no pertenece a ningún clúster.
Requiere dos parámetros esenciales:
- ε (epsilon): radio de vecindad.
- minPts: número mínimo de puntos para que una región se considere densa.
Ventajas
- No necesitas especificar el número de clústeres.
- Detecta clústeres de forma arbitraria.
- Filtra outliers automáticamente.
- Funciona bien cuando los clústeres tienen densidades distintas.
Desventajas
- Elegir los valores adecuados de ε y minPts puede ser complicado.
- No funciona bien si los clústeres tienen densidades muy diferentes.
- La eficiencia baja con muchos atributos (alta dimensionalidad).
Naive Bayes
Es una familia de clasificadores probabilísticos basada en el Teorema de Bayes, con una fuerte suposición de que todas las características son independientes entre sí (de ahí lo de "naive", que significa ingenuo).
A pesar de su simplicidad, funciona sorprendentemente bien en muchos casos, especialmente en clasificación de texto, como spam, análisis de sentimientos, etc.
Ventajas
- Muy rápido en entrenamiento y predicción.
- Funciona bien con datos de texto y alta dimensionalidad.
- No necesita muchos datos para comenzar.
- Robusto ante ruido y datos irrelevantes.
Desventajas
- La independencia entre características rara vez se cumple completamente.
- No aprende relaciones complejas entre variables.
- Puede tener problemas si alguna probabilidad es cero (se usa suavizado de Laplace para corregirlo).
Distribución Gausiana
La distribución gaussiana es una distribución de probabilidad continua que describe cómo se distribuyen los valores de una variable aleatoria alrededor de su media. Es la distribución más común en estadística y ciencia de datos.
También se le llama distribución normal y su característica principal es que forma una campana simétrica.
Propiedades clave
- Simétrica alrededor de la media
- La media, mediana y moda son iguales
- Determinada completamente por dos parámetros
- El área total bajo la curva es 1 (es una distribución de probabilidad)
- Sigue la regla empírica del 68-95-99.7
Isolation Forest
Es un algoritmo de aprendizaje no supervisado diseñado específicamente para la detección de anomalías. A diferencia de otros métodos, no modela la distribución de los datos, sino que intenta "aislar" los puntos anómalos lo más rápido posible.
Las anomalías son más fáciles de aislar porque están lejos o son escasas en comparación con los puntos normales.
¿Cómo funciona?
Isolation Forest crea muchos árboles aleatorios (llamados Isolation Trees) donde:
- En cada árbol:
- Se elige una característica aleatoria.
- Se selecciona un valor aleatorio de corte entre los valores posibles.
- Se divide el conjunto de datos en dos partes.
- Este proceso se repite recursivamente hasta que cada punto esté aislado.
Cuanto más rápido un punto sea aislado (menos divisiones necesarias), más probable es que sea una anomalía.
Idea clave
- Puntos normales → necesitan más divisiones para aislarse.
- Anomalías → se aíslan con menos divisiones.
Ventajas
- No necesita etiquetar los datos (unsupervised).
- Escalable a grandes conjuntos de datos.
- Funciona bien con datos de alta dimensión.
- Rápido en comparación con métodos como SVM o k-NN para detección de outliers.
Desventajas
- No siempre es interpretable.
- No funciona bien si todas las variables son categóricas (mejor con datos numéricos).
- Requiere ajustar el umbral para decidir qué es una anomalía.