Appearance
Aprendizaje supervisado
Son un tipo de algoritmos de aprendizaje automático (machine learning) que aprenden a partir de datos etiquetados. Es decir, el algoritmo recibe ejemplos de entrada junto con las respuestas correctas (etiquetas), y su objetivo es aprender una función que relacione las entradas con las salidas.
SVM Support Vector Machine
Utilizado para la regresión y clasificación. Encuentra la función óptima que mejor separe las clases para la predicción del modelo.
Puede actuar en varias dimensiones superiores según sean los datos de entrada. Detecta la distancia entre los vectores de soporte ( puntos cercanos de cada clase ) para una mejor predicción.
Aplicaciones:
- Clasificación de imágenes y texto
- Detección de fraudes
- Clasificación de genes
SVM busca el hiperplano que maximiza el margen entre dos clases, es decir, la distancia más grande posible entre los puntos más cercanos de cada clase y ese hiperplano.
- Esos puntos más cercanos se llaman vectores de soporte.
- El modelo se define solo por esos puntos, lo que lo hace muy eficiente.
SVM puede usar kernels para transformar los datos a un espacio de mayor dimensión donde sí puedan separarse linealmente. Esto se llama el truco del kernel.
Ventajas
- Funciona bien en espacios de alta dimensión.
- Eficiente cuando el número de características es mayor que el de muestras.
- Flexible gracias a los kernels.
Desventajas
- No escala bien con conjuntos de datos muy grandes.
- Requiere buena selección de hiperparámetros y kernel.
- Difícil de interpretar (no tan explicativo como un árbol de decisión, por ejemplo).
Arboles de decisión
Un árbol de decisión es un modelo de aprendizaje supervisado que se usa tanto para clasificación como para regresión. La idea principal es dividir los datos en subconjuntos más pequeños basándose en decisiones secuenciales, representadas en forma de un árbol.
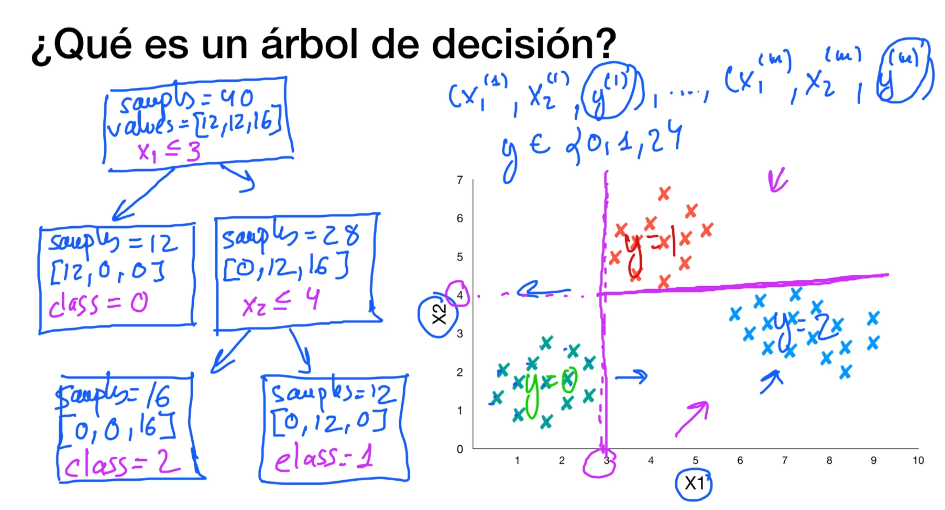
¿Cómo funciona?
- Empieza en un nodo raíz con todos los datos.
- Divide el conjunto de datos en ramas según la característica que mejor separa las clases (en clasificación) o que minimiza el error (en regresión).
- Continúa dividiendo recursivamente hasta que:
- Los datos estén bien clasificados (pura la clase),
- Se alcance un número mínimo de ejemplos,
- O se llegue a una profundidad máxima
Criterios comunes para dividir nodos:
- Clasificación:
- Gini impurity
- Entropía (basada en la teoría de la información)
- Regresión:
- Error cuadrático medio (MSE)
- Varianza
Ventajas
- Muy fácil de interpretar y visualizar.
- Requiere poca preparación de datos.
- Soporta variables categóricas y numéricas.
- Puede capturar relaciones no lineales.
Desventajas
- Puede sobreajustarse fácilmente (overfitting).
- Puede ser inestable: pequeños cambios en los datos generan árboles diferentes.
- No generaliza tan bien como otros modelos más complejos si no se poda o se controla su profundidad.
No requieren escalar los datos
Ensemble learning
Es una técnica en aprendizaje automático que combina varios modelos individuales (llamados estimadores) para crear un modelo más robusto, preciso y generalizable que cualquiera de los modelos por separado. Se pueden generar varios modelos con el mismo algoritmo.
¿Por qué usar ensemble learning?
Porque varios modelos débiles (o incluso buenos pero diferentes) pueden complementarse entre sí, reduciendo errores como:
- Sesgo (cuando el modelo es demasiado simple)
- Varianza (cuando el modelo es demasiado complejo)
- Ruido (irregularidades aleatorias en los datos)
Tipos principales de Ensemble Learning
1. Bagging (Bootstrap Aggregating)
- Entrena múltiples modelos en subconjuntos aleatorios de los datos.
- Se pueden repetir ejemplos de los datos de entrada.
- Promedia (regresión) o vota (clasificación) los resultados.
- Reduce la varianza.
Random Forest
Se dividen los conjuntos de datos en grupos aleatorios. Elije un subconjunto de datos aleatorio de entre los datos de ejemplos para crear los árboles de decisión. Se usa también para eliminar las características del conjunto de datos que no aportan valor al modelo.
2. Boosting
- Entrena modelos de forma secuencial, donde cada nuevo modelo corrige los errores del anterior.
- Se enfoca más en los ejemplos mal clasificados.
- Reduce el sesgo y mejora el rendimiento.
3. Stacking (Stacked Generalization)
- Combina varios modelos diferentes (llamados modelos base) y usa otro modelo (metamodelo) para aprender cómo combinarlos mejor.